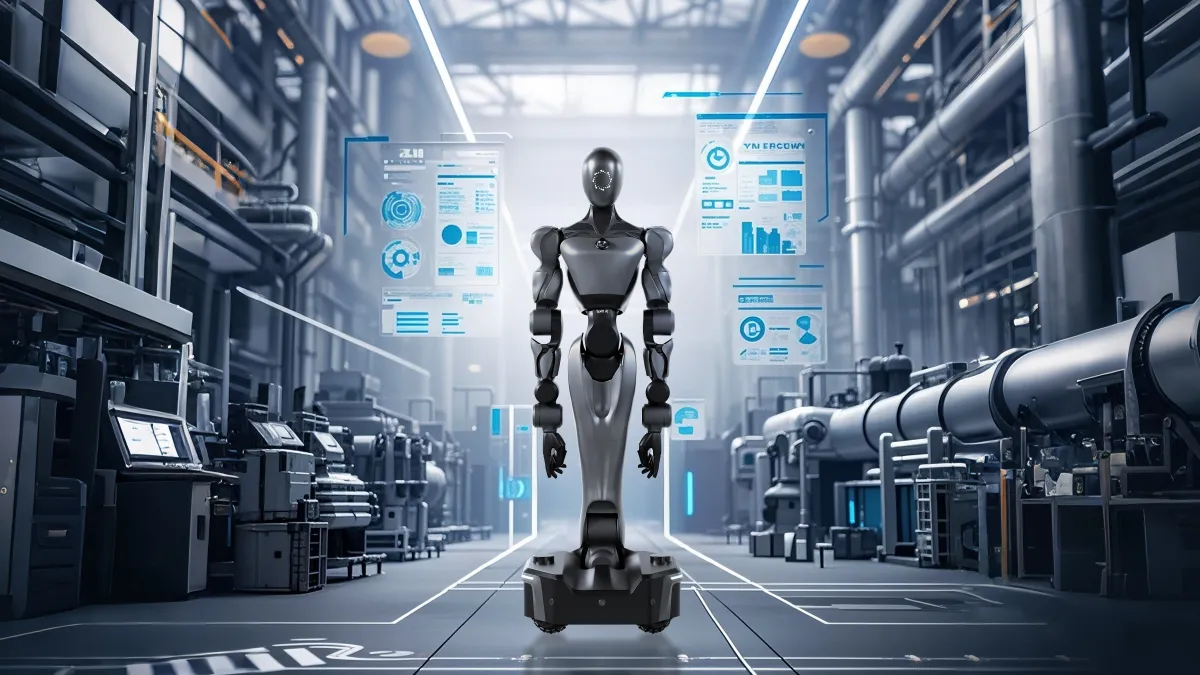
VLA·로봇 파운데이션 모델이란
카메라로 본 것(Vision)과 명령어(Language)를 곧바로 로봇 동작(Action)으로 바꾸는 VLA 모델 — 작업마다 따로 짜던 제어 코드를 하나의 큰 모델로 대체하려는 시도와, 중국 업체들이 공개한 개발 현황.
기준일 2026-09-29 — 수치·현황은 이 날짜에 출처로 확인한 값입니다.
지금까지 로봇 팔이나 휴머노이드를 움직이는 일반적인 방법은 사람이 작업마다 동작을 설계하는 것이었다. 물건의 위치를 계산하고, 경로를 짜고(모션 플래닝), 예외 상황마다 규칙을 붙인다. 이 방식은 정해진 공정에서는 정확하지만, 처음 보는 물건이나 환경이 나오면 다시 프로그래밍해야 한다.
VLA(Vision-Language-Action) 모델은 이 과정을 하나의 학습된 모델로 바꾸려는 접근이다. 대표적인 출발점인 Google DeepMind의 RT-2(2023년 7월)는 카메라 이미지와 자연어 명령을 입력받아 로봇 동작을 출력하는데, 동작을 글자 조각(텍스트 토큰)처럼 표현해 인터넷 규모 데이터로 학습한 시각-언어 모델에 함께 학습시켰다. 논문은 이 덕분에 학습 데이터에 없던 명령을 해석하는 등 일반화 능력이 나타났다고 보고했다. [1]
'로봇 파운데이션 모델'은 여기서 한 걸음 더 나가, 한 모델이 여러 종류의 로봇과 여러 작업을 함께 다루게 하려는 시도를 가리킨다. 2023년 10월 공개된 Open X-Embodiment 프로젝트는 21개 기관이 22종의 로봇에서 모은 527개 기술(160,266개 작업) 데이터를 하나로 묶어, 서로 다른 로봇에 걸쳐 학습하는 모델(RT-X)을 실험했다. [2]
미국 스타트업 Physical Intelligence의 π0(2024년 10월)는 사전 학습된 시각-언어 모델 위에 동작을 연속적으로 생성하는 방식(flow matching)을 얹었다. 논문은 한 팔 로봇·양팔 로봇·이동형 매니퓰레이터에서 빨래 개기, 테이블 정리, 상자 조립 같은 작업을 평가했다. [3]
중국에서는 AgiBot(智元)이 2025년 3월 100만 건 이상의 로봇 동작 궤적과 217개 작업으로 이뤄진 데이터 플랫폼 AgiBot World와, 이를 학습한 범용 정책 모델 GO-1(Genie Operator-1)을 논문으로 공개했다. 논문은 GO-1이 Open X-Embodiment로 학습한 정책보다 30% 높은 성능을 보였고 복잡한 작업에서 60% 이상의 성공률을 냈다고 밝혔다 — 연구진이 설계한 과제에서의 자체 평가다. [4]
휠형 휴머노이드 Moz1을 만든 千寻智能(Spirit AI)은 자체 VLA 모델 Spirit v1을 탑재했다고 보도됐고, 회사 소개 페이지는 후속 모델 Spirit v1.5가 RoboChallenge 벤치마크에서 선두라고 밝히고 있다(회사 주장). [5][6]
정리하면 VLA는 '보고(Vision) → 이해하고(Language) → 움직인다(Action)'를 한 모델 안에서 처리하려는 구조이고, 파운데이션 모델은 그 모델을 여러 로봇과 작업에 두루 쓰려는 방향이다. 둘 다 대량의 로봇 동작 데이터가 전제된다 — 그 데이터가 어디서 오는지는 다음 글에서 다룬다.
VLA가 바꾸는 것은 경쟁의 축이다. 하드웨어 사양(자유도·토크) 외에 '얼마나 많은, 얼마나 쓸모 있는 동작 데이터로 학습했는가'가 성능을 가르는 변수가 된다. 이 사이트의 DB가 여전히 사양 중심인 이유는 모델 성능을 기종 간에 비교할 공통 지표가 아직 없기 때문이다.
논문과 회사 발표의 성공률은 대부분 각 팀이 고른 작업·환경에서의 자체 평가다. 실패했을 때 로봇이 안전하게 멈추는지, 실제 현장 배치에서 VLA 단독으로 운용되는지는 공개 자료로 확인하기 어렵다.
회사가 '자체 VLA'를 내세울 때 확인할 것: ① 논문·모델 가중치를 공개했는가 ② 어떤 과제에서, 몇 번 시도해 측정한 성공률인가 ③ 제3자 벤치마크 결과가 있는가.
- [1]RT-2: Vision-Language-Action Models (Google DeepMind, arXiv 2307.15818, 2023-07-28)ACADEMIC2026-09-29arxiv.org ↗
- [2]Open X-Embodiment: Robotic Learning Datasets and RT-X Models (arXiv 2310.08864, 2023-10-13)ACADEMIC2026-09-29arxiv.org ↗
- [3]π0: A Vision-Language-Action Flow Model (Physical Intelligence, arXiv 2410.24164, 2024-10-31)ACADEMIC2026-09-29arxiv.org ↗
- [4]AgiBot World Colosseo — 대규모 조작 데이터·GO-1 (arXiv 2503.06669, 2025-03-09)ACADEMIC2026-09-29arxiv.org ↗
- [5]证券时报 — 千寻智能 WAIC 2025 첫 참가, Moz1 전시MEDIA2026-09-29stcn.com ↗
- [6]Spirit AI 공식 — 회사 소개(Spirit 시리즈 모델)OFFICIAL2026-09-29spirit-ai.com ↗